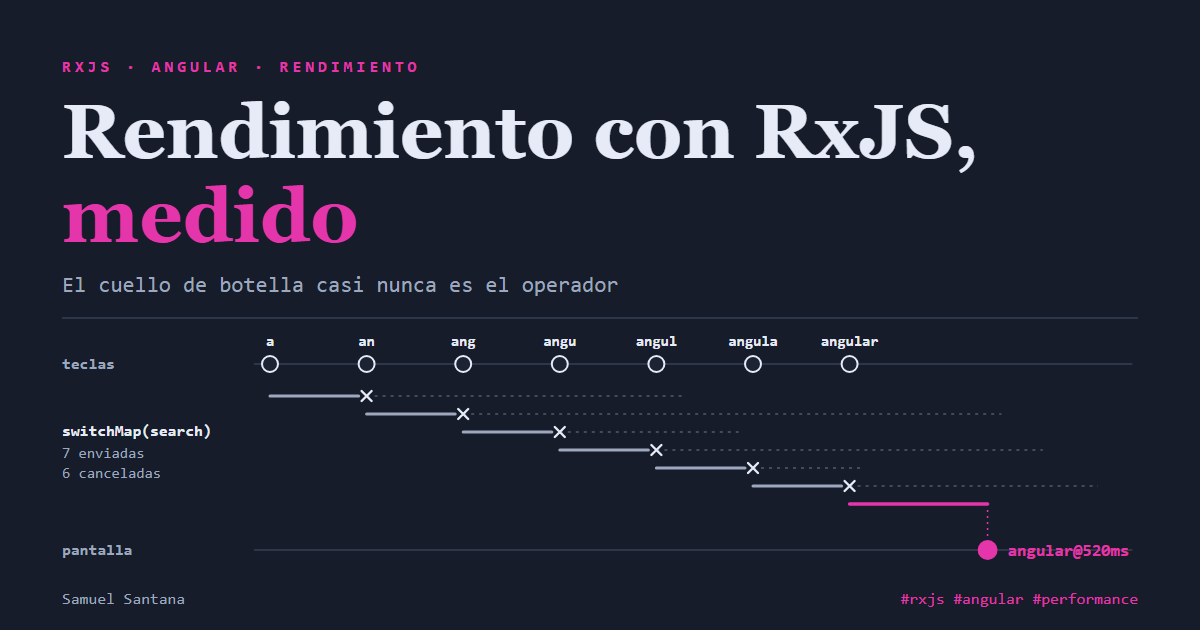
Rendimiento con RxJS, medido: el cuello de botella casi nunca es el operador
 Samuel Santana
Una pregunta que aparece bajo "RxJS performance" es si RxJS es lento. Lo medí. En mi máquina, cada operador de una cadena cuesta entre 8 y 12 nanosegundos por valor. No es gratis, pero casi nunca es el problema. Lo que veo costar caro en una aplicación Angular es otra cosa: la misma petición disparada tres veces, una fuente que sigue corriendo después de que la pantalla se fue, un valor derivado que emite dos veces (una de ellas con datos incorrectos) y un buscador que termina mostrando el resultado de una tecla vieja.
Este post mide cada uno de esos casos con un script corto que se puede ejecutar. La versión es RxJS 7.8.2, la latest en npm hoy, 5 de octubre de 2026. Existe una 9.0.0-beta.0 en la etiqueta next desde el 4 de agosto de 2026, que no medí; y Angular 22.2.1, la versión actual, declara rxjs como peer en ^6.5.3 || ^7.4.0, así que la 9 todavía no es opción en un proyecto Angular. Ejecuté todo en Node 24.19.0, en un Intel Core i9-13900H con Windows. Los tiempos dependen de la máquina. Los conteos (cuántas peticiones, cuántas emisiones, cuántos teardowns) no: son semántica de RxJS y dan el mismo resultado en cualquier lugar.
Continúa dos posts anteriores: RxJS vs. Signals, de julio, y los operators de rx-state-bridge, de agosto.
Primero, la regla: cuánto cuesta un operador
Antes de hablar de lo que cuesta caro, vale la pena medir lo que todos sospechan. El script empuja un millón de valores por cadenas de 0, 5 y 10 operadores, alternando map y filter (el filtro siempre deja pasar, así que cada valor recorre la cadena entera). Después compara con los mismos diez pasos escritos como funciones comunes, y mide suscribir y desuscribir una cadena de cinco operadores, que es lo que hace un pipe async en cada fila de una lista. Cada caso tiene cinco rondas de calentamiento y 21 rondas medidas; la salida muestra la mediana, el mínimo y el máximo.
// node --expose-gc cost.mjs
import { Subject, filter, map } from 'rxjs';

function bench(label, iterations, fn, rounds = 21) {
  for (let i = 0; i < 5; i++) fn(iterations); // calentamiento
  const ns = [];
  for (let i = 0; i < rounds; i++) {
    const t0 = process.hrtime.bigint();
    fn(iterations);
    ns.push(Number(process.hrtime.bigint() - t0) / iterations);
  }
  ns.sort((a, b) => a - b);
  console.log(`${label.padEnd(38)} median ${ns[rounds >> 1].toFixed(1)} ns (min ${ns[0].toFixed(1)}, max ${ns.at(-1).toFixed(1)})`);
}

// map y filter alternados; el filter siempre deja pasar, así que cada valor recorre toda la cadena.
const ops = (n) => Array.from({ length: n }, (_, i) => (i % 2 ? filter((x) => x >= 0) : map((x) => x + 1)));
let sink = 0;

for (const n of [0, 5, 10]) {
  const subject = new Subject();
  subject.pipe(...ops(n)).subscribe((x) => (sink += x));
  bench(`emit through ${n} operators`, 1e6, (it) => { for (let i = 0; i < it; i++) subject.next(i); });
}

const fns = Array.from({ length: 10 }, (_, i) => (i % 2 ? (x) => (x >= 0 ? x : x) : (x) => x + 1));
bench('same 10 steps, plain functions', 1e6, (it) => {
  for (let i = 0; i < it; i++) { let x = i; for (const f of fns) x = f(x); sink += x; }
});

const piped$ = new Subject().pipe(...ops(5));
bench('subscribe + unsubscribe, 5 operators', 1e5, (it) => {
  for (let i = 0; i < it; i++) piped$.subscribe((x) => (sink += x)).unsubscribe();
});

global.gc();
const before = process.memoryUsage().heapUsed;
const subs = Array.from({ length: 1e5 }, () => piped$.subscribe((x) => (sink += x)));
global.gc();
console.log(`heap per live subscription, 5 operators: ${((process.memoryUsage().heapUsed - before) / 1e5).toFixed(0)} bytes`);
subs.forEach((s) => s.unsubscribe());
emit through 0 operators               median 22.7 ns (min 21.0, max 25.4)
emit through 5 operators               median 64.4 ns (min 62.5, max 66.5)
emit through 10 operators              median 120.7 ns (min 107.3, max 150.2)
same 10 steps, plain functions         median 30.9 ns (min 29.1, max 33.8)
subscribe + unsubscribe, 5 operators   median 494.6 ns (min 475.1, max 595.7)
heap per live subscription, 5 operators: 3265 bytes
Ejecuté el benchmark cinco veces (una con este script, cuatro con una versión anterior que solo cambia las etiquetas). La mediana de los 10 operadores quedó entre 121 y 144 ns; la de suscribir y desuscribir, entre 484 y 740 ns. La memoria por suscripción dio 3.265 o 3.266 bytes en todas.
Traduciendo los números:
- Cada operador agrega de 8 a 12 ns por valor. Diez operadores cuestan unas cuatro veces los mismos pasos como llamadas directas a funciones. El overhead existe.
- A 60 Hz, un cuadro dura 16,7 ms. Incluso con la peor mediana (144 ns por valor), la cadena de diez operadores necesitaría más de 110 mil emisiones dentro de un solo cuadro para ocuparlo entero por sí sola.
- Una lista de mil filas con un pipe
asyncpor fila, sobre una cadena de cinco operadores, tarda entre 0,5 y 0,75 ms en montar las mil suscripciones y ocupa unos 3 MB de heap (mil veces 3.265 bytes) mientras existen.
Lo que el número no dice: mide solo RxJS, sin la detección de cambios de Angular y sin DOM. Y se midió en Node. Node usa V8, el mismo motor de Chrome, así que el orden de magnitud debería mantenerse en Chrome; el valor absoluto cambia con la CPU y con el estado del JIT. Firefox y Safari usan otros motores, y no medí en ellos.
Esto le pone escala a una frase del post de julio, que cuenta la sobrecarga de memoria de cada pipe async entre los dolores de RxJS: "en listas largas, este costo se acumula". Se acumula, pero despacio: mil suscripciones cuestan menos de un milisegundo en montarse. Lo que pesa en una lista larga es el trabajo que dispara cada suscripción. El resto del post trata de eso.
La misma petición, tres veces
HttpClient devuelve Observables fríos. La documentación de Angular es directa: ninguna petición ocurre hasta que alguien se suscribe, y suscribirse varias veces al mismo Observable dispara varias peticiones al backend, una por suscripción. Una plantilla con user$ | async en tres lugares hace tres peticiones.
El script de abajo imita ese comportamiento con un Observable que cuenta cuántas veces se ejecutó. Tres consumidores se suscriben juntos, como tres pipes async en la misma plantilla; un cuarto se suscribe después de que llegó la respuesta, como un componente hijo creado más tarde.
import { Observable, share, shareReplay } from 'rxjs';

const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

// Igual que HttpClient: nada ocurre hasta el subscribe, y cada subscribe es una petición.
const fakeGet = (stats) =>
  new Observable((subscriber) => {
    stats.requests++;
    const t = setTimeout(() => { subscriber.next({ name: 'Ada' }); subscriber.complete(); }, 50);
    return () => clearTimeout(t);
  });

async function scenario(label, operator) {
  const stats = { requests: 0 };
  const user$ = operator ? fakeGet(stats).pipe(operator) : fakeGet(stats);
  for (let i = 0; i < 3; i++) user$.subscribe(); // tres `user$ | async` en la misma plantilla
  await sleep(100);
  const atOnce = stats.requests;
  user$.subscribe(); // un componente creado después de que llegó la respuesta
  await sleep(100);
  console.log(`${label.padEnd(46)} 3 at once: ${atOnce} | +1 late: ${stats.requests} total`);
}

await scenario('no sharing', null);
await scenario('share()', share());
await scenario('shareReplay(1)', shareReplay(1));
await scenario('shareReplay({ bufferSize: 1, refCount: true })', shareReplay({ bufferSize: 1, refCount: true }));
no sharing                                     3 at once: 3 | +1 late: 4 total
share()                                        3 at once: 1 | +1 late: 2 total
shareReplay(1)                                 3 at once: 1 | +1 late: 1 total
shareReplay({ bufferSize: 1, refCount: true }) 3 at once: 1 | +1 late: 1 total
Tres cosas de esa tabla merecen atención.
share() resuelve a quien llega junto, no a quien llega después. El cuarto suscriptor disparó otra petición. Es el comportamiento por defecto del operador: en el código de share, resetOnComplete empieza en true, y la documentación de ShareConfig explica que, con él activo, el Observable vuelve al estado "frío" cuando la fuente completa. Una petición HTTP completa justo después de la respuesta.
shareReplay(1) guarda el último valor y se lo entrega a quien llega después. La documentación de shareReplay avisa el precio: una fuente que completó con éxito queda en caché en el Observable compartido para siempre. Una fuente que terminó con error puede reintentarse.
refCount: true no apaga ese caché. El cuarto suscriptor recibió el valor guardado sin petición nueva, incluso con refCount: true e incluso habiendo llegado a cero el conteo de suscriptores antes de él. El motivo está en el código de share: el reset por conteo cero solo ocurre si la fuente todavía no completó ni falló. O sea, refCount decide qué pasa con una fuente viva cuando todos se van. No decide si el resultado de una petición queda guardado.
En la plantilla, la corrección más barata ni siquiera usa un operador. Es una sola suscripción, con alias:
@if (user$ | async; as user) {
  <app-avatar [user]="user" />
  <h2>{{ user.name }}</h2>
  <app-permissions [roles]="user.roles" />
}
La otra es llamar a toSignal una vez, en un campo de la clase, y leer el signal donde haga falta. La documentación de interoperabilidad avisa que toSignal crea una suscripción, así que no debe llamarse repetidamente para el mismo Observable. Un detalle del alias: @if no renderiza el bloque cuando el valor es falsy. Para un objeto de usuario, bien; para un contador que puede valer cero, no.
shareReplay sin refCount: una fuga, no lentitud
El refCount por defecto de shareReplay es false. La documentación dice lo que eso significa: cuando el conteo de suscriptores llega a cero, la fuente no se desuscribe, y el ReplaySubject interno puede correr para siempre. Es una decisión deliberada, pensada para mantener vivas fuentes caras de montar. El problema aparece cuando se usa donde nadie quería eso.
Medí dos casos. En el caso A, el usuario sale de la pantalla 20 ms después de que empieza la petición, y la petición tardaría 100 ms. En el caso B, la fuente nunca completa: un interval hace de polling o websocket. La pantalla se monta y se desmonta mil veces, y en cada montaje dos suscriptores entran y salen.
// node --expose-gc refcount.mjs
import { Observable, interval, shareReplay } from 'rxjs';

const sleep = (ms) => new Promise((r) => setTimeout(r, ms));
const timers = () => process.getActiveResourcesInfo().filter((r) => r === 'Timeout').length;
const heapMiB = () => (global.gc(), process.memoryUsage().heapUsed / 2 ** 20);

const variants = {
  'shareReplay(1)': () => shareReplay(1),
  'shareReplay({ bufferSize: 1, refCount: true })': () => shareReplay({ bufferSize: 1, refCount: true }),
};

// A) El usuario se va mientras la petición sigue en curso.
for (const [label, op] of Object.entries(variants)) {
  let aborted = 0, processed = 0;
  const req$ = new Observable((s) => {
    let done = false;
    const t = setTimeout(() => { done = true; processed++; s.next('data'); s.complete(); }, 100);
    return () => { if (!done) aborted++; clearTimeout(t); };
  }).pipe(op());
  const sub = req$.subscribe();
  await sleep(20);
  sub.unsubscribe(); // componente destruido
  await sleep(150);
  console.log(`A ${label.padEnd(46)} aborted: ${aborted} | processed anyway: ${processed}`);
}

// B) Una fuente que nunca completa (polling, websocket), mil ciclos de montar y desmontar.
for (const [label, op] of Object.entries(variants)) {
  const baseTimers = timers(), baseHeap = heapMiB();
  let ticks = 0, teardowns = 0;
  for (let i = 0; i < 1000; i++) {
    const ticker$ = new Observable((s) => {
      const sub = interval(10).subscribe((n) => { ticks++; s.next(n); });
      return () => { teardowns++; sub.unsubscribe(); };
    }).pipe(op());
    const a = ticker$.subscribe(), b = ticker$.subscribe();
    a.unsubscribe(); b.unsubscribe(); // todos los consumidores se fueron
  }
  const atExit = ticks;
  await sleep(500);
  console.log(`B ${label.padEnd(46)} teardowns: ${teardowns}/1000 | live timers: ${timers() - baseTimers}` +
    ` | callbacks in the next 500 ms: ${ticks - atExit} | retained: ${(heapMiB() - baseHeap).toFixed(2)} MiB`);
}
process.exit(0); // los intervals filtrados mantendrían vivo a Node para siempre
A shareReplay(1)                                 aborted: 0 | processed anyway: 1
A shareReplay({ bufferSize: 1, refCount: true }) aborted: 1 | processed anyway: 0
B shareReplay(1)                                 teardowns: 0/1000 | live timers: 1000 | callbacks in the next 500 ms: 32000 | retained: 2.66 MiB
B shareReplay({ bufferSize: 1, refCount: true }) teardowns: 1000/1000 | live timers: 0 | callbacks in the next 500 ms: 0 | retained: 0.05 MiB
En el caso A, con shareReplay(1), la petición llegó hasta el final y la respuesta se procesó para nadie. Con refCount: true, se abortó. En HttpClient, desuscribirse antes de la respuesta aborta la petición en curso (está en la misma guía de peticiones), pero solo si el unsubscribe llega hasta la fuente. shareReplay(1) lo detiene a mitad de camino.
En el caso B, el teardown de la fuente no se ejecutó ni una vez en mil montajes. Quedaron mil timers vivos, que dispararon 32 mil callbacks en los 500 ms siguientes (en esta máquina Windows, el intervalo de 10 ms se disparó más o menos cada 16 ms), y 2,66 MiB de heap siguieron retenidos después de la recolección de basura, contra 0,05 MiB con refCount: true. Eso no es lentitud de operador. Es trabajo que nunca se detiene, y que crece con cada navegación.
Fíjate que, en memoria, el caso A es casi inofensivo: la petición completa y la fuente se detiene sola. Una fuga de verdad necesita una fuente que no completa. Polling, websockets, valueChanges de formularios, Router.events y selectores de store son fuentes así. La regla que sigo: en un componente, o en cualquier cosa que viva menos que la aplicación, shareReplay({ bufferSize: 1, refCount: true }). refCount: false solo para un caché que deba durar toda la aplicación, y a propósito.
takeUntilDestroyed en el lugar equivocado
takeUntilDestroyed completa el Observable cuando se destruye el contexto que lo llamó (componente, directiva, servicio). En el código de @angular/core 22.2.1, la implementación es literalmente source.pipe(takeUntil(destroyed$)). Por eso su posición en el pipe importa tanto como la de takeUntil, y un Subject haciendo de DestroyRef reproduce el comportamiento:
import { Subject, interval, switchMap, takeUntil } from 'rxjs';

const sleep = (ms) => new Promise((r) => setTimeout(r, ms));
const timers = () => process.getActiveResourcesInfo().filter((r) => r === 'Timeout').length;

async function scenario(label, build) {
  const route$ = new Subject();     // por ejemplo, parámetros de ruta
  const destroyed$ = new Subject(); // por ejemplo, DestroyRef.onDestroy
  const pollOrder = () => interval(10); // consulta un endpoint cada 10 ms
  const baseTimers = timers();
  let received = 0;
  build(route$, destroyed$, pollOrder).subscribe(() => received++);

  route$.next('order-42');
  await sleep(100);
  destroyed$.next(); // componente destruido
  const atDestroy = received;
  await sleep(300);
  console.log(`${label.padEnd(34)} values after destroy: ${received - atDestroy} | timers still running: ${timers() - baseTimers}`);
}

await scenario('takeUntil before switchMap', (route$, destroyed$, poll) =>
  route$.pipe(takeUntil(destroyed$), switchMap(poll)));
await scenario('takeUntil after switchMap (last)', (route$, destroyed$, poll) =>
  route$.pipe(switchMap(poll), takeUntil(destroyed$)));
process.exit(0); // el interval filtrado mantendría vivo el proceso
takeUntil before switchMap         values after destroy: 20 | timers still running: 1
takeUntil after switchMap (last)   values after destroy: 0 | timers still running: 0
Con takeUntil antes de switchMap, la destrucción completó el flujo externo, pero el polling interno siguió: 20 valores en los 300 ms posteriores al destroy, y el timer todavía corriendo cuando el script terminó. El motivo está en el código de switchMap: la salida solo completa cuando el flujo externo completó y no hay una suscripción interna activa. Un polling nunca completa, así que la salida tampoco. Con takeUntil al final, el unsubscribe baja por toda la cadena y el polling se detiene.
La regla, entonces: takeUntilDestroyed() es el último operador antes del subscribe. O no te suscribas a mano y deja que el pipe async o toSignal se encarguen, que es lo que recomienda la guía de peticiones.
El diamante: dos emisiones, una de ellas incorrecta
La documentación de combineLatest describe el comportamiento en una frase: siempre que cualquier Observable de entrada emite, calcula la salida con los valores más recientes de todos. Cuando las entradas derivan de la misma fuente, un cambio en la fuente se convierte en dos emisiones, y la primera combina un valor nuevo con uno viejo.
En el ejemplo, subtotal$ y total$ derivan del mismo carrito. En un estado consistente, total - subtotal es siempre el envío, 10. El script cuenta cuántas emisiones llegan y cuántas rompen esa regla, y repite el mismo diamante con signal y computed de Angular, que corren en Node sin ninguna aplicación:
import { BehaviorSubject, combineLatest, map } from 'rxjs';
import { computed, signal } from '@angular/core';

const N = 1000;

// RxJS: dos valores derivados de la misma fuente, combinados de nuevo.
const cart$ = new BehaviorSubject({ subtotal: 100, shipping: 10 });
const subtotal$ = cart$.pipe(map((c) => c.subtotal));
const total$ = cart$.pipe(map((c) => c.subtotal + c.shipping));
let emissions = 0, inconsistent = 0;
combineLatest([subtotal$, total$]).subscribe(([subtotal, total]) => {
  emissions++;
  if (total - subtotal !== 10) inconsistent++; // estado consistente: la diferencia es el envío
});
emissions = inconsistent = 0; // ignora la emisión inicial
for (let i = 1; i <= N; i++) cart$.next({ subtotal: 100 + i, shipping: 10 });
console.log(`combineLatest: ${N} updates -> ${emissions} emissions, ${inconsistent} inconsistent`);

// Signals de Angular: el mismo diamante con computed.
const cart = signal({ subtotal: 100, shipping: 10 });
const subtotal = computed(() => cart().subtotal);
const total = computed(() => cart().subtotal + cart().shipping);
let evaluations = 0;
inconsistent = 0;
const summary = computed(() => {
  evaluations++;
  if (total() - subtotal() !== 10) inconsistent++;
  return `${subtotal()} / ${total()}`;
});
summary();
evaluations = 0;
for (let i = 1; i <= N; i++) { cart.set({ subtotal: 100 + i, shipping: 10 }); summary(); }
console.log(`computed, read after each set: ${N} updates -> ${evaluations} evaluations, ${inconsistent} inconsistent`);
evaluations = 0;
for (let i = 1; i <= N; i++) cart.set({ subtotal: 5000 + i, shipping: 10 });
summary();
console.log(`computed, read once at the end: ${N} updates -> ${evaluations} evaluation`);
combineLatest: 1000 updates -> 2000 emissions, 1000 inconsistent
computed, read after each set: 1000 updates -> 1000 evaluations, 0 inconsistent
computed, read once at the end: 1000 updates -> 1 evaluation
Mil actualizaciones del carrito se convirtieron en 2.000 emisiones, y la mitad traía un total que no cuadraba con el subtotal. El efecto en pantalla no lo medí: las dos emisiones ocurren en la misma tarea síncrona, antes de que Angular renderice. Lo que sí puedo afirmar es lo que viene después del combineLatest: todo ahí se ejecuta dos veces por cambio (un tap que escribe, un log, un switchMap que arma una consulta), y una de esas ejecuciones recibe valores que nunca existieron juntos.
La corrección en RxJS es no crear el diamante: derivar los dos valores en el mismo map, a partir de la misma emisión. Ejecuté la variante cart$.pipe(map((c) => [c.subtotal, c.subtotal + c.shipping])) con las mismas mil actualizaciones: mil emisiones, ninguna inconsistente.
Con signals, el diamante no produce lecturas inconsistentes: mil evaluaciones cuando el computed se lee después de cada set, ninguna incorrecta, y una sola evaluación cuando se lee una vez después de mil sets. Eso coincide con lo que describe la guía de signals: el valor de un computed queda en caché y solo se recalcula en la siguiente lectura después de que cambió una dependencia. En el post de julio afirmé que computed es glitch-free; esta es la medición que le faltaba.
distinctUntilChanged ayuda, con una condición
La otra manera de generar trabajo de más es emitir un valor igual al anterior. distinctUntilChanged existe para eso, y su documentación dice cómo compara: con el comparador que le pases o, sin comparador, con ===. Esa última parte decide si sirve para algo:
import { BehaviorSubject, distinctUntilChanged, map } from 'rxjs';

const N = 1000;
function count(label, buildPipe, updates) {
  const source$ = new BehaviorSubject(updates(0));
  let runs = 0;
  buildPipe(source$).subscribe(() => runs++);
  runs = 0; // ignora la emisión inicial
  for (let i = 1; i <= N; i++) source$.next(updates(i));
  console.log(`${label.padEnd(52)} ${N} updates -> ${runs} downstream runs`);
}

const price = (i) => 101 + (i % 100); // siempre "caro"
count('boolean, no distinctUntilChanged', (p$) => p$.pipe(map((p) => p > 100)), price);
count('boolean + distinctUntilChanged()', (p$) => p$.pipe(map((p) => p > 100), distinctUntilChanged()), price);

const state = (i) => ({ user: { name: 'Ada' }, lastSeen: i }); // el nombre nunca cambia
count('view model + distinctUntilChanged()',
  (s$) => s$.pipe(map((s) => ({ name: s.user.name })), distinctUntilChanged()), state);
count('view model + distinctUntilChanged((a, b) => a.name === b.name)',
  (s$) => s$.pipe(map((s) => ({ name: s.user.name })), distinctUntilChanged((a, b) => a.name === b.name)), state);
boolean, no distinctUntilChanged                     1000 updates -> 1000 downstream runs
boolean + distinctUntilChanged()                     1000 updates -> 0 downstream runs
view model + distinctUntilChanged()                  1000 updates -> 1000 downstream runs
view model + distinctUntilChanged((a, b) => a.name === b.name) 1000 updates -> 0 downstream runs
Con un booleano, el operador reduce las mil ejecuciones a cero. Con un objeto armado en un map, distinctUntilChanged() sin argumentos no filtra nada: cada map crea un objeto nuevo, y === entre objetos distintos siempre es falso. Se vuelve un operador que cuesta y no hace nada. Con el comparador, vuelve a cero.
El mismo cuidado vale del lado de los signals. La igualdad por defecto de un signal es referencial (Object.is, según la guía), así que un objeto nuevo con el mismo contenido cuenta como cambio.
Typeahead: switchMap, mergeMap, concatMap y exhaustMap
El último caso es concurrencia. Un buscador recibe siete teclas, una cada 70 ms, hasta formar "angular". Cada consulta tiene una latencia fija en el servidor simulado, elegida para provocar una carrera: la segunda ("an") es la más lenta, 460 ms, y la última ("angular") es la más rápida, 100 ms. El script usa tiempo virtual (TestScheduler.run), así que imprime exactamente los mismos números en cada ejecución.
// Las mismas teclas y las mismas latencias pasando por cada operador de aplanamiento.
import { NEVER, Observable, concatMap, debounceTime, exhaustMap, map, merge, mergeMap, switchMap, timer } from 'rxjs';
import { TestScheduler } from 'rxjs/testing';

const QUERIES = ['a', 'an', 'ang', 'angu', 'angul', 'angula', 'angular'];
const TYPED_AT = [0, 70, 140, 210, 280, 350, 420]; // una tecla cada 70 ms
const LATENCY = { a: 300, an: 460, ang: 200, angu: 350, angul: 150, angula: 250, angular: 100 };

function run(label, flatten) {
  const scheduler = new TestScheduler(() => {});
  const stats = { started: 0, cancelled: 0, delivered: 0, inFlight: 0, maxInFlight: 0, shown: [] };

  scheduler.run(() => {
    const search = (q) =>
      new Observable((subscriber) => {
        stats.started++;
        stats.maxInFlight = Math.max(stats.maxInFlight, ++stats.inFlight);
        let done = false;
        const response = timer(LATENCY[q]).subscribe(() => {
          done = true;
          stats.inFlight--;
          subscriber.next(q);
          subscriber.complete();
        });
        return () => {
          if (!done) { stats.cancelled++; stats.inFlight--; }
          response.unsubscribe();
        };
      });

    // NEVER mantiene la entrada abierta, como un campo de texto real (debounceTime emite antes si la fuente completa).
    const keystrokes$ = merge(...QUERIES.map((q, i) => timer(TYPED_AT[i]).pipe(map(() => q))), NEVER);
    flatten(keystrokes$, search).subscribe((q) => {
      stats.delivered++;
      stats.shown.push(`${q}@${scheduler.now()}ms`);
    });
  });

  const last = stats.shown.at(-1);
  console.log(
    `${label.padEnd(28)} sent ${stats.started} | not sent ${QUERIES.length - stats.started} | ` +
    `cancelled ${stats.cancelled} | max in flight ${stats.maxInFlight} | ` +
    `screen ends on "${last}"${last.startsWith('angular@') ? '' : '  <-- stale'}`
  );
}

run('mergeMap', (k$, s) => k$.pipe(mergeMap(s)));
run('concatMap', (k$, s) => k$.pipe(concatMap(s)));
run('exhaustMap', (k$, s) => k$.pipe(exhaustMap(s)));
run('switchMap', (k$, s) => k$.pipe(switchMap(s)));
run('debounceTime(200)+switchMap', (k$, s) => k$.pipe(debounceTime(200), switchMap(s)));
mergeMap                     sent 7 | not sent 0 | cancelled 0 | max in flight 5 | screen ends on "angula@600ms"  <-- stale
concatMap                    sent 7 | not sent 0 | cancelled 0 | max in flight 1 | screen ends on "angular@1810ms"
exhaustMap                   sent 2 | not sent 5 | cancelled 0 | max in flight 1 | screen ends on "angula@600ms"  <-- stale
switchMap                    sent 7 | not sent 0 | cancelled 6 | max in flight 1 | screen ends on "angular@520ms"
debounceTime(200)+switchMap  sent 1 | not sent 6 | cancelled 0 | max in flight 1 | screen ends on "angular@720ms"
mergeMap llegó a tener cinco peticiones en vuelo al mismo tiempo, y las respuestas se mostraron en el orden en que el servidor terminó. La pantalla termina en "angula", a los 600 ms: la respuesta correcta llegó a los 520 ms y fue sobrescrita por una más lenta. Con un backend local respondiendo todo en tiempos parecidos, esta carrera puede no aparecer nunca en desarrollo.
exhaustMap ignora valores nuevos mientras el anterior no terminó (es su definición en la documentación). Envió dos peticiones y también terminó en "angula". Incorrecto para un buscador, correcto para un botón de enviar, donde el segundo clic debe ignorarse.
concatMap acierta, pero tarda 1.810 ms: la suma de todas las latencias, porque cada petición espera a la anterior. La documentación además avisa que, si los valores llegan más rápido de lo que completan los internos, se acumulan en un buffer sin límite.
switchMap acierta en 520 ms. Pero envió siete peticiones y canceló seis. La cancelación ocurre en el cliente: HttpClient despacha la petición en el subscribe y la aborta en el unsubscribe, como dice la documentación, pero abortar no deshace lo que el servidor ya recibió.
debounceTime(200) + switchMap envió una sola petición y acertó, en 720 ms. El intercambio es explícito: 200 ms más de latencia por seis peticiones menos. Cuál de los dos vale más depende del costo de la consulta en el backend.
Una trampa en la que caí escribiendo la prueba: en la primera versión, el flujo de teclas completaba después de la última tecla, y debounceTime emitía en el acto, sin esperar los 200 ms. La documentación de debounceTime lo describe: si la fuente completa durante la espera, el último valor guardado se emite antes de la finalización. Un campo de texto real nunca completa; el NEVER en el merge reproduce eso.
En Angular 22, rxResource es estable desde la 22.0 y ofrece la semántica de switchMap sin escribirlo. La guía de resources dice que un resource aborta la carga en curso cuando cambian los parámetros, y en el código de 22.2.1 ese aborto hace unsubscribe del Observable anterior. Si los parámetros devuelven undefined, la carga ni siquiera empieza y el estado queda en idle:
import { Component, inject, signal } from '@angular/core';
import { HttpClient } from '@angular/common/http';
import { rxResource } from '@angular/core/rxjs-interop';

interface Product {
  id: string;
  name: string;
}

@Component({ selector: 'app-product-search', template: `...` })
export class ProductSearch {
  private http = inject(HttpClient);
  query = signal('');

  results = rxResource({
    // un string vacío se vuelve undefined: sin petición, estado 'idle'
    params: () => this.query() || undefined,
    stream: ({ params }) => this.http.get<Product[]>('/api/products', { params: { q: params } }),
  });
}
El debounce sigue siendo cosa tuya. Y un detalle que documenta el tipado de 22.2.1: si el Observable completa sin emitir nada (un catchError(() => EMPTY), por ejemplo), Angular lanza el error NG0991, porque el resource queda sin valor y sin error que mostrar. Quien migre un typeahead que tragaba errores con catchError(() => EMPTY) dentro del switchMap necesita devolver un valor (of([])) o dejar que el error llegue al resource.
Por qué esto importa
Las mediciones forman una escalera. Un operador cuesta nanosegundos. Una suscripción cuesta medio microsegundo y poco más de 3 KB. Lo que cuesta milisegundos, megabytes o un número incorrecto en pantalla siempre es trabajo: repetido (tres peticiones en lugar de una), que nunca se detiene (mil timers después de que todos se fueron), emitido de más (dos emisiones del diamante por cada cambio) o en el orden equivocado (mergeMap mostrando "angula").
Ninguno de estos problemas aparece en un profiler como "RxJS es lento". Aparecen como peticiones duplicadas en la pestaña de red, memoria que sube con cada navegación, un total que parpadea y un buscador que muestra resultados viejos. Por eso, cuando investigo rendimiento con RxJS, cuento en lugar de cronometrar: cuántas veces se ejecutó el productor, cuántos teardowns ocurrieron, cuántas emisiones llegaron. Contar es barato, da el mismo resultado en cada ejecución y vale igual en Node y en el navegador. Los nanosegundos no.
Referencias
- RxJS —
shareReplay - RxJS —
shareyShareConfig - RxJS —
combineLatest - RxJS —
distinctUntilChanged - RxJS —
switchMap,mergeMap,concatMap,exhaustMap - RxJS —
debounceTime - Angular — Making HTTP requests
- Angular —
AsyncPipe - Angular —
@if - Angular — RxJS interop (
toSignal,rxResource) - Angular —
takeUntilDestroyed - Angular —
rxResource - Angular — Signals y Resource
- V8
- Código fuente consultado:
rxjs@7.8.2(src/internal/operators/share.ts,shareReplay.ts,switchMap.ts) y@angular/core@22.2.1(fesm2022/rxjs-interop.mjs,types/rxjs-interop.d.ts)
Comentarios
Cargando comentarios...