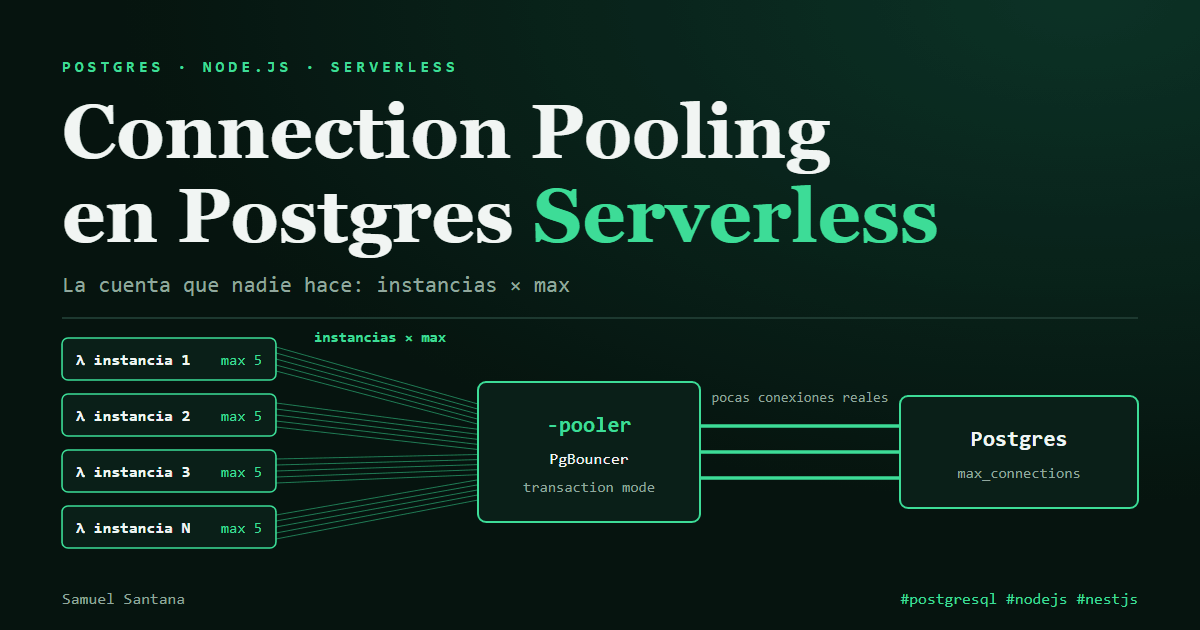
Connection Pooling en Postgres Serverless: Por Qué Tu API se Cae en Producción
 Samuel Santana
Funciona perfectamente en tu localhost. Pasa el CI. Funciona en staging con dos usuarios de prueba. Después subes a producción, el tráfico crece un poco y la API empieza a devolver too many connections o, peor, prepared statement "s1" already exists, un error que no tiene ningún sentido para quien nunca escribió un PREPARE en su vida.
Eso rara vez es un bug de tu código. Es la física de las conexiones de base de datos chocando con la física de los entornos serverless, y la mayoría de los tutoriales de Node con Postgres no habla de esto.
Hice esta cuenta cuando la API de este blog, vertex-api, se fue a AWS Lambda y empezó a hablar con el Postgres de Neon por el endpoint con pooler. Lo que sigue es el razonamiento que quedó escrito en el código.
La conexión es cara, y serverless multiplica a quien la pide
Una conexión Postgres no es un keep-alive de HTTP barato. Cada conexión es un proceso en el servidor de la base y ocupa memoria real, y Postgres tiene un techo rígido, max_connections. En los servicios gestionados, ese techo acompaña el tamaño de la máquina: en un compute pequeño del plan gratuito de Neon, queda en unos pocos cientos.
En un backend tradicional, abres un pool de N conexiones al arrancar el proceso y lo reutilizas. Un proceso, un pool, todo predecible.
En serverless, cada instancia abre su propio pool. En Lambda estándar (sin Managed Instances), cada entorno de ejecución atiende una petición a la vez y guarda el pool congelado entre invocaciones. Con 50 entornos simultáneos, cada uno con un pool de 10 conexiones porque ese es el valor por defecto de postgres.js, acabas de autorizar hasta 500 conexiones a la base. Lo mismo vale, a menor escala, para un NestJS con varias réplicas escalando en horizontal.
La cuenta:
(máximo de instancias simultáneas) × (tamaño del pool por instancia)tiene que quedar por debajo delmax_connectionsde la base, con margen. Si nunca hiciste esta cuenta, probablemente vas a reventar el límite en un pico de tráfico que todavía no ocurrió.
Por qué hay un pooler delante de la base
La respuesta estándar es que la aplicación no hable directo con Postgres, sino con un connection pooler. PgBouncer es el más conocido; Neon y Supabase ofrecen uno gestionado, en general en un endpoint separado. En Neon, es el hostname con el sufijo -pooler.
El pooler mantiene pocas conexiones reales con Postgres y multiplexa cientos de conexiones lógicas de la aplicación sobre ellas. Para la API, las conexiones parecen ilimitadas; en la práctica, el pooler hace malabares por detrás. Y la cuenta de la sección anterior cambia de lugar: instancias × max pasa a chocar con el límite de clientes del pooler, que es mucho mayor, y el límite físico pasa a ser el pool del propio pooler.
El detalle que sorprende a todos está en el modo de pooling:
- Session mode: la conexión del cliente queda atada a una conexión real hasta que se desconecta. Se parece a una conexión directa y no resuelve la escala.
- Transaction mode: la conexión real solo pertenece a tu sesión durante una transacción. Cuando termina, la conexión vuelve al pool y puede atender a otro cliente. Es el modo del endpoint
-poolerde Neon, porque es lo que permite multiplexar de verdad.
El transaction mode tiene un precio: lo que vive en la sesión, y no en la transacción, se pierde entre una transacción y la siguiente. SET, LISTEN/NOTIFY, los advisory locks de sesión y las tablas temporales dejan de comportarse como esperas. Antes de cambiar la URL, confirma que la aplicación no depende de ninguno de ellos. En vertex-api, esa verificación quedó escrita en el propio código: no se usa ninguno, y los tres lugares que abren una transacción hacen todo su trabajo dentro de ella.
Prepared statements: el consejo viejo y por qué los desactivo igual
Los prepared statements del protocolo de Postgres también viven en la conexión física, no en tu sesión lógica. Si el driver prepara una query en una transacción y la siguiente transacción cae en otra conexión física, Postgres se queja de que el statement no existe. Si el nombre choca con el de otro cliente, se queja de que ya existe. Los dos errores tienen la misma causa.
Durante años la recomendación fue una sola: detrás de un pooler en transaction mode, desactiva los prepared statements. Ese consejo envejeció. PgBouncer 1.21, de 2023, empezó a rastrear los prepared statements del protocolo (la opción max_prepared_statements) y a recrearlos en la conexión donde caiga la siguiente transacción; desde la 1.24 viene activado por defecto. El pooler de Neon los rastrea. Lo que sigue rompiéndose es el PREPARE escrito en SQL, que PgBouncer no ve.
Aun así, vertex-api corre con prepare: false, porque aquí equivocarse es asimétrico. Si la caché de statements del driver y la del pooler no coinciden, el síntoma solo aparece con pooling, solo en producción y solo de vez en cuando, como un prepared statement ... does not exist o already exists. En postgres-js, desactivarlos cuesta más que un parse: sin statement con nombre, cada query con parámetros paga un viaje de ida y vuelta extra (Parse/Describe y solo después Bind/Execute). Y con Drizzle la opción no cambia nada: el driver de Drizzle ejecuta todo con sql.unsafe(), que en postgres-js ya corre sin prepared statements por defecto. Por eso la opción queda como resguardo, no como optimización: protege cualquier query que algún día use postgres-js directamente, fuera de Drizzle. Volver a activarla solo tiene sentido cuando una medición diga que importa.
// vertex-api: opciones de toda conexión postgres-js de la aplicación
import type { Options } from 'postgres';

export const postgresClientOptions: Options<Record<string, never>> = {
  // Riesgo asimétrico: un viaje de ida y vuelta más por query con parámetros contra un bug intermitente solo en producción.
  prepare: false,
  // Detrás del pooler, este pool solo cubre las queries en vuelo de un proceso.
  // Lo que llega a Neon es instancias × max.
  max: 5,
  // Segundos: devuelve las conexiones ociosas en vez de retenerlas toda la vida del proceso.
  idle_timeout: 20,
};
El archivo completo, con el razonamiento de cada opción en un comentario, está en vertex-api.
En otras herramientas, la misma decisión aparece con otro nombre:
- Prisma: durante mucho tiempo la solución fue el parámetro
?pgbouncer=trueen la URL, que desactiva los prepared statements del protocolo. Hoy la documentación de Prisma recomienda no usarlo con PgBouncer 1.21 o más nuevo y, en su lugar, activarmax_prepared_statementsen el pooler. - node-postgres (
pg): solo usa prepared statements con nombre cuando se lo pides (query({ name, text, values })). Por eso tiende a ser seguro por accidente, y tampoco gana la caché de plan que un statement con nombre daría en una conexión directa.
El punto en común: la configuración correcta del driver depende de saber de antemano si hay un pooler en transaction mode en el camino, y qué versión tiene. Copiar la configuración de un proyecto con Postgres propio, sin pooler, a un proyecto en Neon o Supabase es una receta para este bug.
Dos URLs, dos propósitos
La práctica que se volvió consenso, popularizada por Prisma pero útil con cualquier ORM, es separar la URL de conexión en dos:
# .env
# Usada por la aplicación en runtime: pasa por el pooler,
# muchas conexiones lógicas, pocas físicas.
DATABASE_URL="postgresql://user:pass@ep-xxx-pooler.sa-east-1.aws.neon.tech/db?sslmode=require"

# Usada solo por migrations y scripts administrativos:
# conexión directa, sin pooler.
DIRECT_URL="postgresql://user:pass@ep-xxx.sa-east-1.aws.neon.tech/db?sslmode=require"
La aplicación usa DATABASE_URL, con pooler. El pipeline de migraciones (drizzle-kit migrate, prisma migrate deploy) usa DIRECT_URL. Las herramientas de migración suelen depender justamente de lo que el transaction mode no conserva: Prisma Migrate, por ejemplo, mantiene un advisory lock de sesión durante toda la migración, y en transaction mode esa sesión no existe.
Cómo detectarlo antes de que sea un incidente
No esperes el error en producción para descubrir el límite. El propio Postgres lo muestra:
-- Cuántas conexiones hay abiertas ahora, por estado
SELECT state, count(*) FROM pg_stat_activity GROUP BY state;

-- El techo configurado
SHOW max_connections;
Detrás de un pooler, pg_stat_activity muestra las conexiones del pooler, no las de la aplicación. El lado de la aplicación aparece en las métricas del pooler y en el gráfico de conexiones de Neon o de Supabase. Ese gráfico es el primer lugar donde mirar cuando la API empieza a devolver errores intermitentes bajo carga que "no tienen sentido". Si la curva de conexiones sube en diente de sierra hasta tocar el techo justo cuando aparecen los errores, encontraste la causa antes de abrir un solo stack trace.
Lo que queda
Serverless no eliminó el problema clásico del connection pooling; solo cambió la matemática. La pregunta dejó de ser "cuántas conexiones necesita mi proceso" y pasó a ser "cuántas conexiones necesita el conjunto de todas las instancias que pueden existir al mismo tiempo". Esa cuenta casi nunca aparece en los tutoriales de "conecta tu Next.js o NestJS a Postgres en 5 minutos".
Trata la conexión de base de datos como un recurso escaso, repartido entre todas las invocaciones simultáneas de la aplicación, y no como un detalle de configuración por instancia. Y desconfía de los consejos de configuración sin fecha: el de los prepared statements valía hasta finales de 2023 y sigue circulando como regla.
Comentarios
Cargando comentarios...