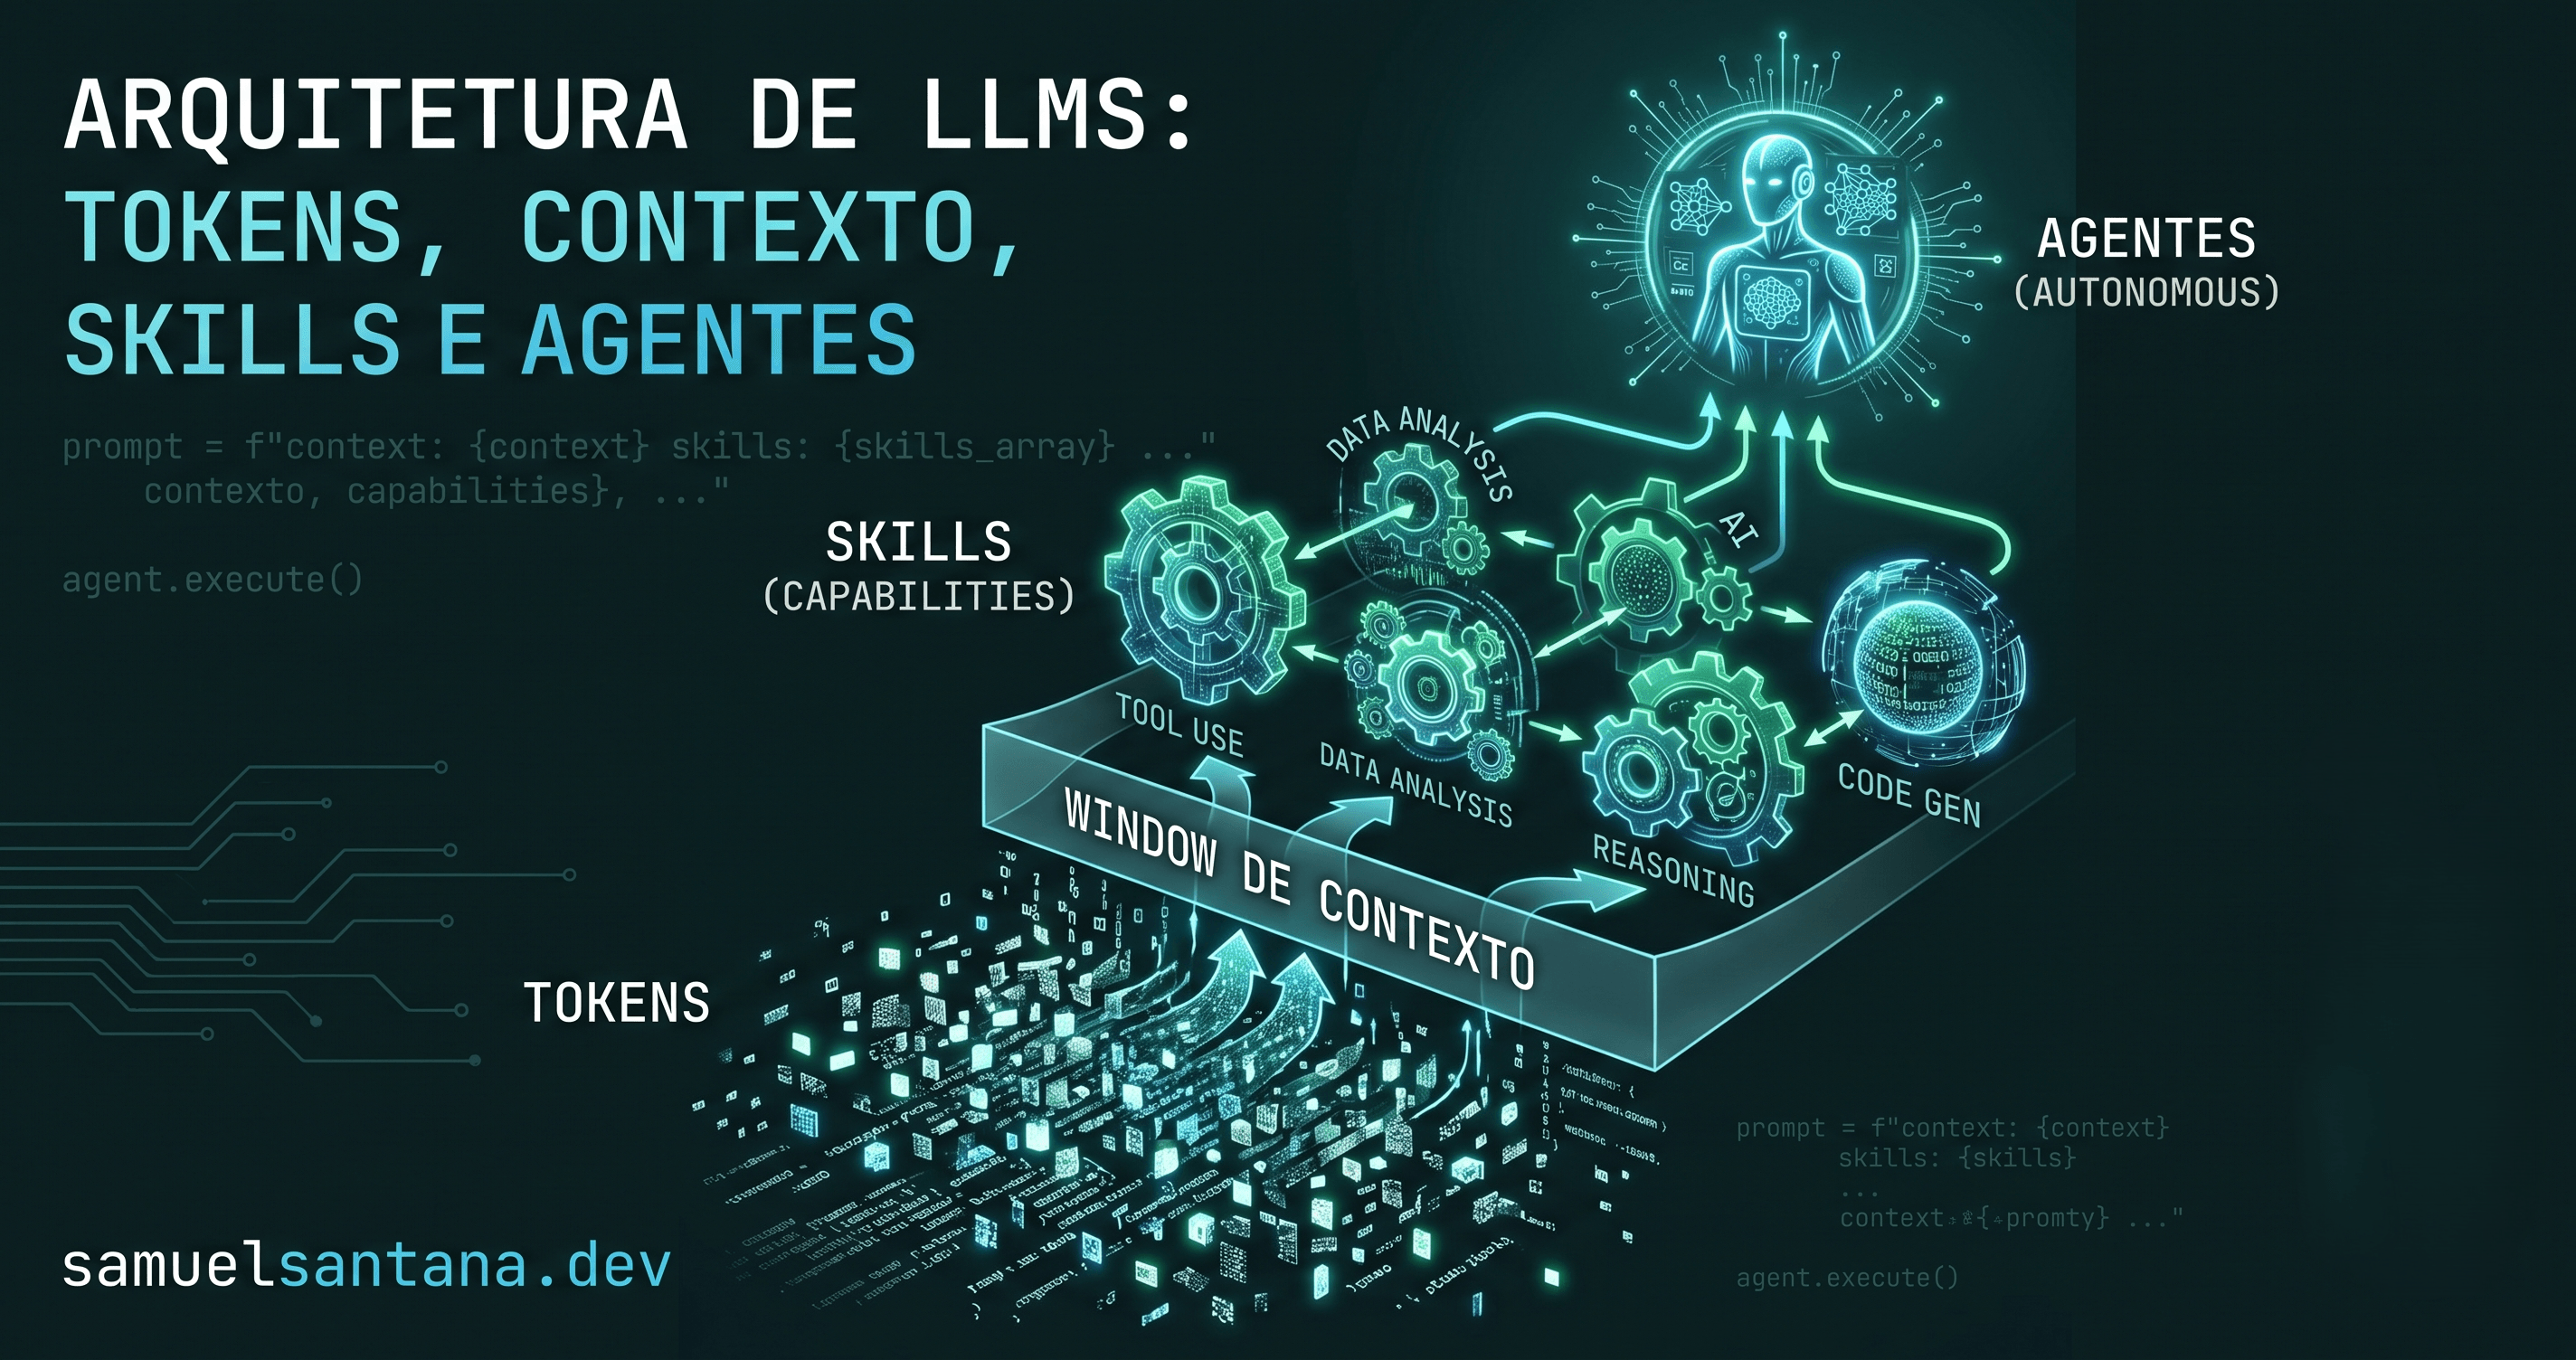
Arquitetura de LLMs: Tokens, Contexto, Skills e Agentes
Estás leyendo la versión en portugués de este artículo. Léelo en Español
 Samuel Santana
A integração de IA generativa deixou de ser apenas sobre interfaces de chat e se tornou um desafio direto de arquitetura de software. Entender o funcionamento do motor dessas ferramentas é o que separa uma chamada de API ineficiente de um sistema autônomo real. O hype passou; agora a discussão é pura engenharia.
Abaixo estão os quatro pilares técnicos que estruturam essa camada.
Tokens
A unidade fundamental de processamento. Modelos de linguagem não interpretam texto corrido, eles processam matrizes numéricas. O texto cru de entrada e saída é fracionado nesses fragmentos chamados tokens. A bilhetagem, a latência e o custo computacional de qualquer requisição dependem desse volume, mas não de forma uniforme: tokens de entrada, de saída e lidos de cache têm preços distintos, e a latência é dominada pelos tokens gerados, não pelos enviados. A eficiência de uma integração é medida pela densidade de informação útil por token gasto, o que exige otimização constante do que entra no contexto.
Janela de contexto (context window)
É a memória de curto prazo da requisição. Cada modelo possui um limite arquitetural restrito de tokens que consegue reter e processar simultaneamente em uma única chamada. Ultrapassar esse limite faz a API recusar a requisição com erro; quem descarta instruções antigas sem avisar é a aplicação ou a interface de chat que corta o histórico para caber na janela. E, mesmo dentro do limite, a precisão cai à medida que o contexto cresce (context rot). Em projetos reais, contornamos essa limitação estrutural evitando o tráfego de bases de dados inteiras. Em vez disso, implementamos pipelines de recuperação de dados que injetam no contexto apenas o escopo estritamente necessário milissegundos antes da submissão final ao modelo.
Skills (Function Calling)
O mecanismo de saída do isolamento estrutural do modelo. É a ponte entre a capacidade analítica da IA e a execução do seu código. Neste artigo, "Skill" é cada capacidade que o seu sistema expõe ao modelo; o mecanismo por trás é tool use, também chamado de function calling. Não confundir com Agent Skills, o padrão aberto de pastas com um SKILL.md de instruções que o agente carrega sob demanda. O modelo recebe as assinaturas das funções e rotinas disponíveis no seu sistema. Ao processar a requisição, em vez de gerar texto livre, ele gera um payload de dados estruturado indicando qual função do seu software deve ser executada. O sistema processa a lógica de negócio e devolve o output para o modelo continuar a operação. É o ponto de contato onde a abstração ganha acesso ao ambiente de produção.
Agentes
O topo da abstração de controle. Diferente de fluxos imperativos tradicionais, a arquitetura baseada em agentes inverte o gerenciamento do sistema. Em vez de declarar um passo a passo linear, define-se um estado final ou um objetivo. O modelo avalia a intenção, seleciona as Skills declaradas no sistema, recebe o retorno da execução de cada uma e decide, em loop, a próxima ação. Representa a transição de um sistema puramente reativo para um sistema autônomo, servindo de base para arquiteturas onde múltiplos agentes isolados colaboram na mesma solução.
Juntando as peças: Como aplicar isso na prática
A teoria é elegante, mas a engenharia acontece na trincheira. Quando você traz esses quatro pilares para o desenvolvimento de um produto real — como um SaaS multi-tenant ou uma arquitetura de micro-frontends —, o fluxo de trabalho muda radicalmente.
Aqui estão exemplos concretos de como orquestrar esses elementos.
1. Otimizando Tokens e Contexto em Logs de Migração
Imagine que você está conduzindo uma migração complexa de sistemas legados para uma nova arquitetura e precisa usar a IA para analisar falhas. Se você jogar um arquivo de log de 50 MB no prompt, vai estourar a Context Window e queimar dinheiro com Tokens inúteis.
A solução real: Você cria um script intermediário que filtra o log localmente. O sistema extrai apenas as linhas que contêm as tags [ERROR] ou [TIMEOUT] referentes a um tenant_id específico. Você empacota apenas esse extrato refinado de texto (agora com apenas 800 tokens) e injeta na Janela de Contexto da requisição. A IA recebe apenas o sinal limpo, sem o ruído, e devolve o diagnóstico do problema de forma rápida e barata.
2. Controlando o Frontend com Skills (Function Calling)
Você quer colocar uma barra de busca inteligente em um dashboard gerencial. O usuário digita: "Filtre os usuários inativos do mês passado".
A IA não tem acesso ao seu banco de dados para fazer isso. É aqui que entram as Skills.
- O Fluxo: Você envia o input do usuário para a IA, passando junto um schema JSON de uma Skill chamada
applyUserFilter(status, dateRange). - A Mágica: A IA não responde com texto amigável. Ela devolve uma chamada estruturada (o formato exato varia por provedor; este é simplificado):
{ "function": "applyUserFilter", "args": { "status": "inactive", "dateRange": "2026-06" } }. - No Frontend: Seu código intercepta essa resposta, valida esses argumentos contra o schema e os aplica no estado da sua aplicação (por exemplo, atualizando um Signal no Angular), e a tabela na tela é renderizada na mesma hora com os dados corretos. A IA operou a interface por você.
3. Orquestrando Agentes para Tarefas Autônomas
Pense em um fluxo de onboarding de um novo cliente no seu sistema SaaS. Em vez de criar um código rígido que bate em 5 APIs diferentes na sequência, você define um Agente de Provisionamento.
Você dá a ele um objetivo: "Configure o ambiente para o novo Tenant X". O Agente, rodando no backend, analisa a tarefa e decide suas próprias ações:
- Ele aciona a Skill
createDatabaseSchema(). - Avalia a resposta (deu sucesso?).
- Aciona a Skill
provisionMicroFrontendRoute(). - Ele percebe que a API de rotas retornou um erro de timeout. Como é um Agente, ele possui autonomia para raciocinar sobre o erro e decide acionar a Skill novamente (retry) sem que você tenha programado esse
if/elseespecífico. Isso só é seguro seprovisionMicroFrontendRoute()for idempotente: um timeout não prova que a rota não foi criada, e repetir uma chamada com efeito colateral sem chave de idempotência pode provisionar duas vezes. - Quando tudo finaliza, ele aciona a Skill
sendSlackNotification()avisando que o ambiente está no ar.
Você deixou de ser um programador de fluxos imperativos e passou a ser um orquestrador de capacidades.
Comentarios
Cargando comentarios...