Connection Pooling em Postgres Serverless: Por Que Sua API Trava em Produção
 Samuel Santana
Funciona perfeitamente no seu localhost. Passa no CI. Funciona em staging com dois usuários de teste. Aí você sobe para produção, o tráfego cresce um pouco e a API começa a devolver too many connections ou, pior, prepared statement "s1" already exists, um erro que não faz sentido nenhum para quem nunca escreveu um PREPARE na vida.
Isso raramente é bug do seu código. É a física das conexões de banco colidindo com a física dos ambientes serverless, e a maioria dos tutoriais de Node com Postgres não fala disso.
Eu fiz essa conta quando a API deste blog, o vertex-api, foi para o AWS Lambda e passou a falar com o Postgres do Neon pelo endpoint com pooler. O que segue é o raciocínio que ficou registrado no código.
Conexão é cara, e serverless multiplica quem pede
Uma conexão Postgres não é um keep-alive de HTTP barato. Cada conexão é um processo no servidor do banco e ocupa memória real, e o Postgres tem um teto rígido, o max_connections. Em serviços gerenciados, esse teto acompanha o tamanho da máquina: num compute pequeno do plano gratuito do Neon, ele fica na casa das poucas centenas.
Num backend tradicional, você abre um pool de N conexões no boot do processo e reaproveita. Um processo, um pool, tudo previsível.
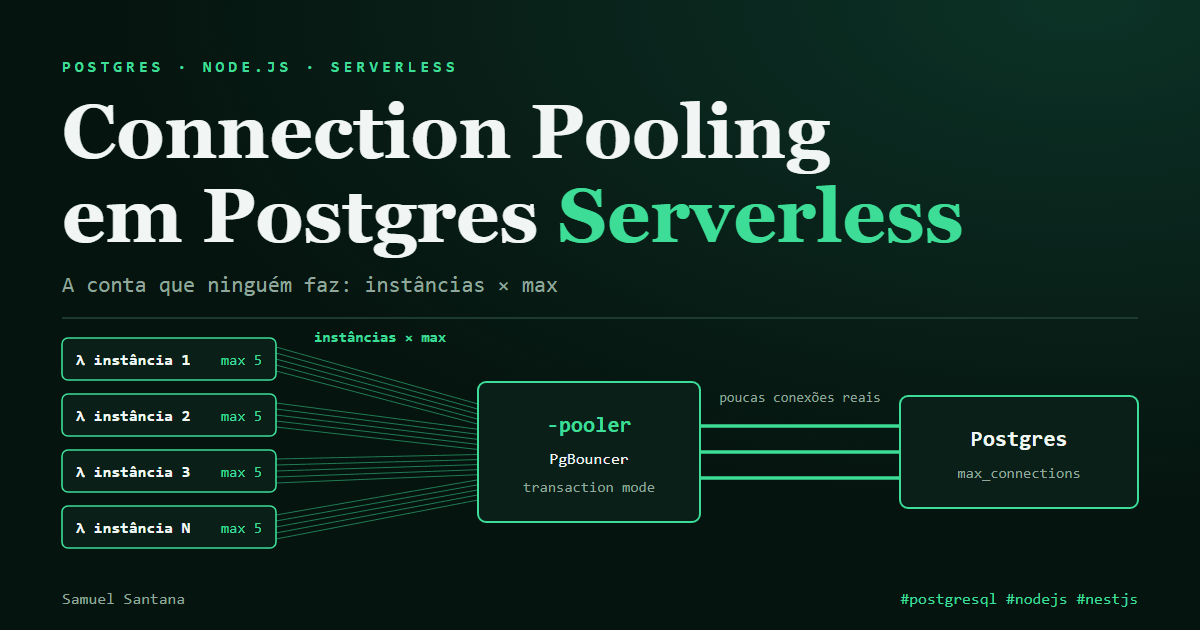
No serverless, cada instância abre o próprio pool. No Lambda padrão (sem Managed Instances), cada ambiente de execução atende uma requisição por vez e guarda o pool congelado entre invocações. Com 50 ambientes simultâneos, cada um com um pool de 10 conexões porque esse é o padrão do postgres.js, você acabou de autorizar até 500 conexões ao banco. O mesmo vale, em escala menor, para um NestJS com várias réplicas escalando na horizontal.
A conta:
(máximo de instâncias simultâneas) × (tamanho do pool por instância)tem de ficar abaixo domax_connectionsdo banco, com margem. Se você nunca fez essa conta, provavelmente vai estourar o limite num pico de tráfego que ainda não aconteceu.
Por que existe um pooler na frente do banco
A resposta padrão é a aplicação não falar direto com o Postgres, e sim com um connection pooler. O PgBouncer é o mais conhecido; Neon e Supabase oferecem um gerenciado, em geral num endpoint separado. No Neon, é o hostname com o sufixo -pooler.
O pooler mantém poucas conexões reais com o Postgres e multiplexa centenas de conexões lógicas da aplicação por cima delas. Para a API, parece que as conexões são ilimitadas; na prática, o pooler faz malabarismo por trás. E a conta da seção anterior muda de lugar: instâncias × max passa a esbarrar no limite de clientes do pooler, que é muito maior, e o limite físico passa a ser o pool do próprio pooler.
O detalhe que pega todo mundo está no modo de pooling:
- Session mode: a conexão do cliente fica presa a uma conexão real até ele desconectar. Parece conexão direta e não resolve a escala.
- Transaction mode: a conexão real só pertence à sua sessão durante uma transação. Quando ela termina, a conexão volta para o pool e pode servir outro cliente. É o modo do endpoint
-poolerdo Neon, porque é o que permite multiplexar de verdade.
Transaction mode tem um preço: o que vive na sessão, e não na transação, se perde entre uma transação e a próxima. SET, LISTEN/NOTIFY, advisory locks de sessão e tabelas temporárias deixam de se comportar como você espera. Antes de trocar a URL, confira que a aplicação não depende de nenhum deles. No vertex-api, essa conferência ficou escrita no próprio código: nada disso é usado, e os três lugares que abrem transação fazem todo o trabalho dentro dela.
Prepared statements: o conselho antigo e por que eu desligo mesmo assim
Os prepared statements do protocolo do Postgres também vivem na conexão física, não na sua sessão lógica. Se o driver prepara uma query numa transação e a próxima transação cai em outra conexão física, o Postgres reclama que o statement não existe. Se o nome colide com o de outro cliente, reclama que ele já existe. Os dois erros têm a mesma causa.
Por anos, a recomendação foi uma só: atrás de um pooler em transaction mode, desligue os prepared statements. Esse conselho envelheceu. O PgBouncer 1.21, de 2023, passou a rastrear os prepared statements do protocolo (a opção max_prepared_statements) e a recriá-los na conexão em que a próxima transação cair; a partir do 1.24, isso vem ligado por padrão. O pooler do Neon rastreia esses statements. O que continua quebrando é o PREPARE escrito em SQL, que o PgBouncer não enxerga.
Mesmo assim, o vertex-api roda com prepare: false, porque aqui o erro é assimétrico. Se o cache de statements do driver e o do pooler discordarem, o sintoma só aparece com pooling, só em produção e só de vez em quando, como um prepared statement ... does not exist ou already exists. No postgres-js, desligar custa mais que um parse: sem statement nomeado, cada query com parâmetros paga uma ida e volta extra (Parse/Describe e só depois Bind/Execute). E, com Drizzle, a opção não muda nada: o driver do Drizzle executa tudo por sql.unsafe(), que no postgres-js já roda sem prepared statement por padrão. Por isso a opção fica como trava, não como otimização: protege qualquer query que um dia use o postgres-js direto, fora do Drizzle. Religar só faz sentido com uma medição dizendo que importa.
// vertex-api: opções de toda conexão postgres-js da aplicação
import type { Options } from 'postgres';

export const postgresClientOptions: Options<Record<string, never>> = {
  // Erro assimétrico: uma ida e volta a mais por query com parâmetros contra um bug intermitente só em produção.
  prepare: false,
  // Atrás do pooler, este pool só cobre as queries em voo de um processo.
  // O que chega ao Neon é instâncias × max.
  max: 5,
  // Segundos: devolve conexões ociosas em vez de segurá-las pela vida do processo.
  idle_timeout: 20,
};
O arquivo completo, com o raciocínio de cada opção num comentário, está no vertex-api.
Em outras ferramentas, a mesma decisão aparece com outro nome:
- Prisma: por muito tempo, a solução foi o parâmetro
?pgbouncer=truena URL, que desliga os prepared statements do protocolo. Hoje a documentação do Prisma recomenda não usá-lo com PgBouncer 1.21 ou mais novo e, em vez disso, ligar omax_prepared_statementsno pooler. - node-postgres (
pg): só usa prepared statements com nome quando você pede (query({ name, text, values })). Por isso tende a ser seguro por acidente, e também não ganha o cache de plano que um statement com nome daria numa conexão direta.
O ponto comum: a configuração certa do driver depende de saber de antemão se há um pooler em transaction mode no caminho, e qual a versão dele. Copiar a configuração de um projeto com Postgres próprio, sem pooler, para um projeto no Neon ou no Supabase é receita para esse bug.
Duas URLs, dois propósitos
A prática que virou consenso, popularizada pelo Prisma mas útil com qualquer ORM, é separar a URL de conexão em duas:
# .env
# Usada pela aplicação em runtime: passa pelo pooler,
# muitas conexões lógicas, poucas físicas.
DATABASE_URL="postgresql://user:pass@ep-xxx-pooler.sa-east-1.aws.neon.tech/db?sslmode=require"

# Usada só por migrations e scripts administrativos:
# conexão direta, sem pooler.
DIRECT_URL="postgresql://user:pass@ep-xxx.sa-east-1.aws.neon.tech/db?sslmode=require"
A aplicação usa DATABASE_URL, com pooler. O pipeline de migração (drizzle-kit migrate, prisma migrate deploy) usa DIRECT_URL. Ferramentas de migração costumam depender justamente do que o transaction mode não preserva: o Prisma Migrate, por exemplo, segura um advisory lock de sessão durante a migração inteira, e em transaction mode essa sessão não existe.
Como detectar antes que vire incidente
Não espere o erro em produção para descobrir o limite. O próprio Postgres mostra:
-- Quantas conexões estão abertas agora, por estado
SELECT state, count(*) FROM pg_stat_activity GROUP BY state;

-- O teto configurado
SHOW max_connections;
Atrás de um pooler, pg_stat_activity mostra as conexões do pooler, não as da aplicação. O lado da aplicação aparece nas métricas do pooler e no gráfico de conexões do Neon ou do Supabase. Esse gráfico é o primeiro lugar a olhar quando a API começa a devolver erros intermitentes sob carga que "não fazem sentido". Se a curva de conexões sobe em serrote até bater no teto exatamente quando os erros aparecem, você achou a causa antes de abrir uma única stack trace.
O que fica
Serverless não eliminou o problema clássico de connection pooling; só mudou a matemática. A pergunta deixou de ser "quantas conexões meu processo precisa" e virou "quantas conexões o conjunto de todas as instâncias que podem existir ao mesmo tempo precisa". Essa conta quase nunca aparece nos tutoriais de "conecte seu Next.js ou NestJS ao Postgres em 5 minutos".
Trate a conexão de banco como um recurso escasso, dividido entre todas as invocações simultâneas da aplicação, e não como um detalhe de configuração por instância. E desconfie de conselho de configuração sem data: o dos prepared statements valia até o fim de 2023 e continua circulando como regra.
Comentários
Carregando comentários...